网站 GEO 怎么做?让 AI 引用和推荐你的网站
大家好!
最近我发现,自己查东西越来越少直接点搜索结果了。先问 ChatGPT、Claude,或者看一眼 Google 顶上的 AI 摘要,觉得答案靠谱,再点它引用的链接。
用户的习惯在变,做网站的人也要跟着想一想:当用户问 AI 一个问题时,AI 的答案里有没有我的网站?当用户让 AI 推荐一个工具时,AI 会不会推荐我?
这就是现在常说的 GEO(Generative Engine Optimization,生成式引擎优化)。我把它分成两件事:
- 让 AI 了解和引用你:爬虫能进来,内容能被读懂、被摘出来
- 让 AI 主动推荐你:用户问“有没有好用的 xxx”时,答案里有你的网站,并且用户愿意点进来
网上关于 GEO 的说法很多,有些说得很玄,好像要学一套全新的技术。我自己做了一段时间,结论是:GEO 不是替代 SEO,而是在 SEO 的基础上多做几步。
本文分享我做网站 GEO 时会做的几件事,主要以 Google、ChatGPT、Claude、Perplexity 为例,不是标准答案,欢迎一起交流。
先搞清楚 AI 是怎么引用网站的
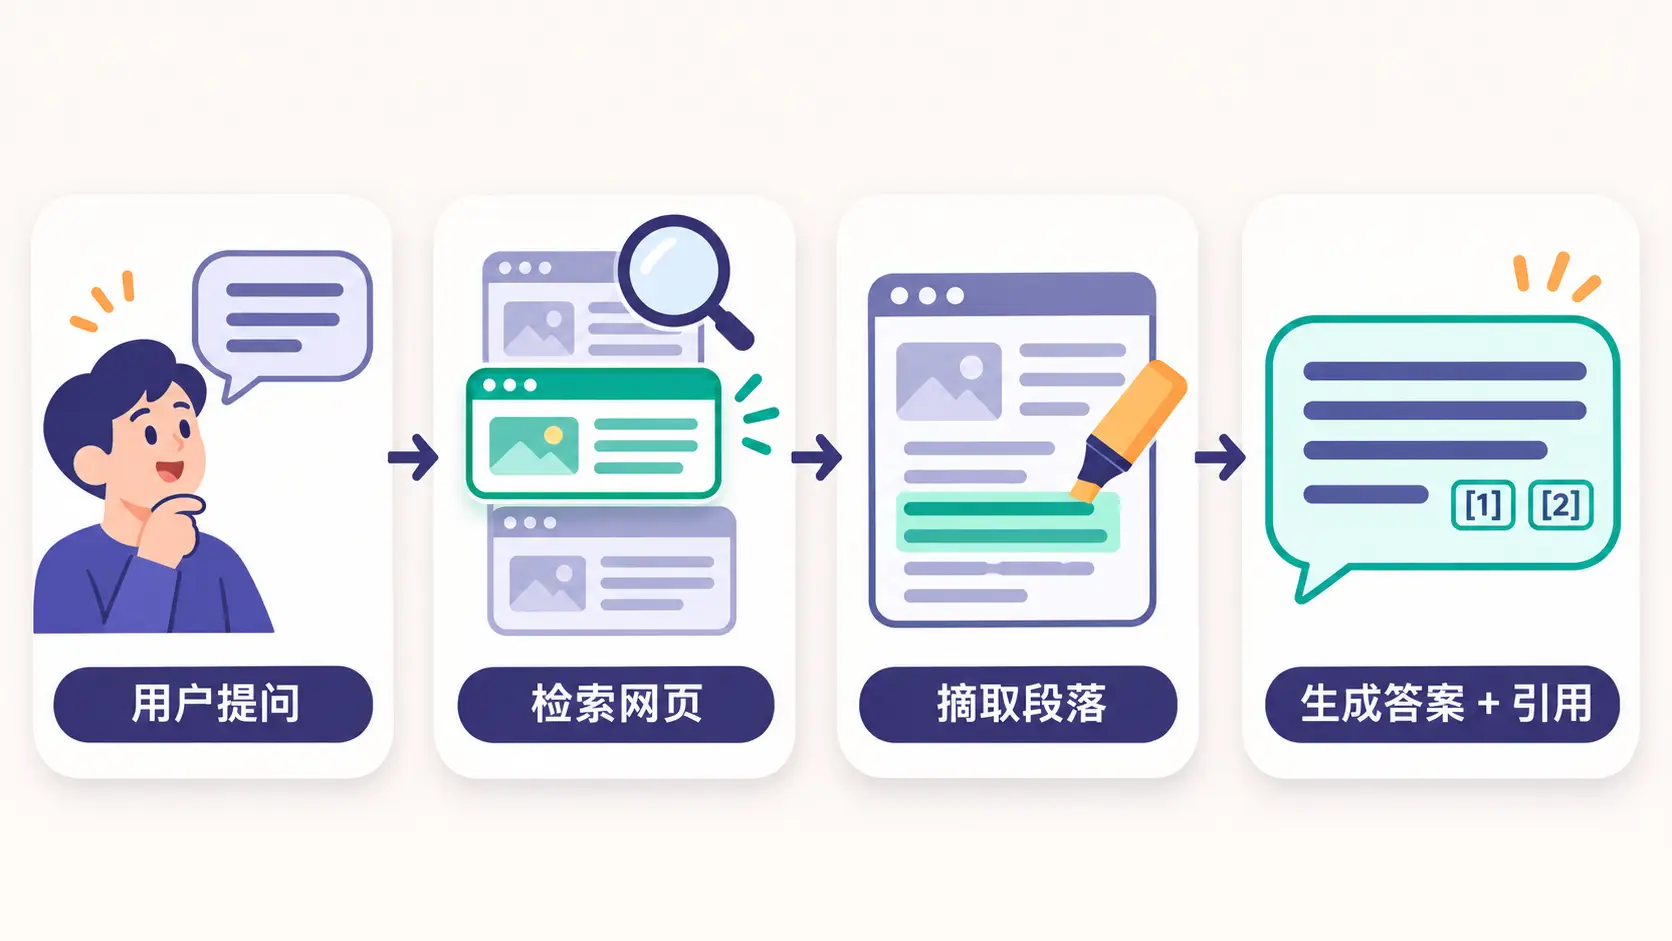
现在主流的 AI 搜索,大致流程是这样的:
- 用户提问
- AI 去自己的搜索索引里检索相关网页
- 从网页里摘取能回答问题的段落
- 生成答案,并附上引用来源
所以想被 AI 引用,前提有两个:
- AI 的搜索爬虫能抓到你的页面,并且收录进它的索引
- 你的页面里有能被直接摘出来的答案
很多人一上来就研究怎么写“AI 喜欢的内容”,结果第一步就没过,爬虫根本进不来。
另外说一下 Google 的态度。Google 官方文档明确说,想出现在 AI 概览(AI Overviews)和 AI 模式里,没有额外的技术要求,页面只要被收录,并且可以带摘要展示在搜索结果中,就有资格被引用。SEO 的基本功在这里仍然适用。
Google AI 功能与您的网站: https://developers.google.com/search/docs/appearance/ai-features
检查 robots.txt,分清三类 AI 爬虫
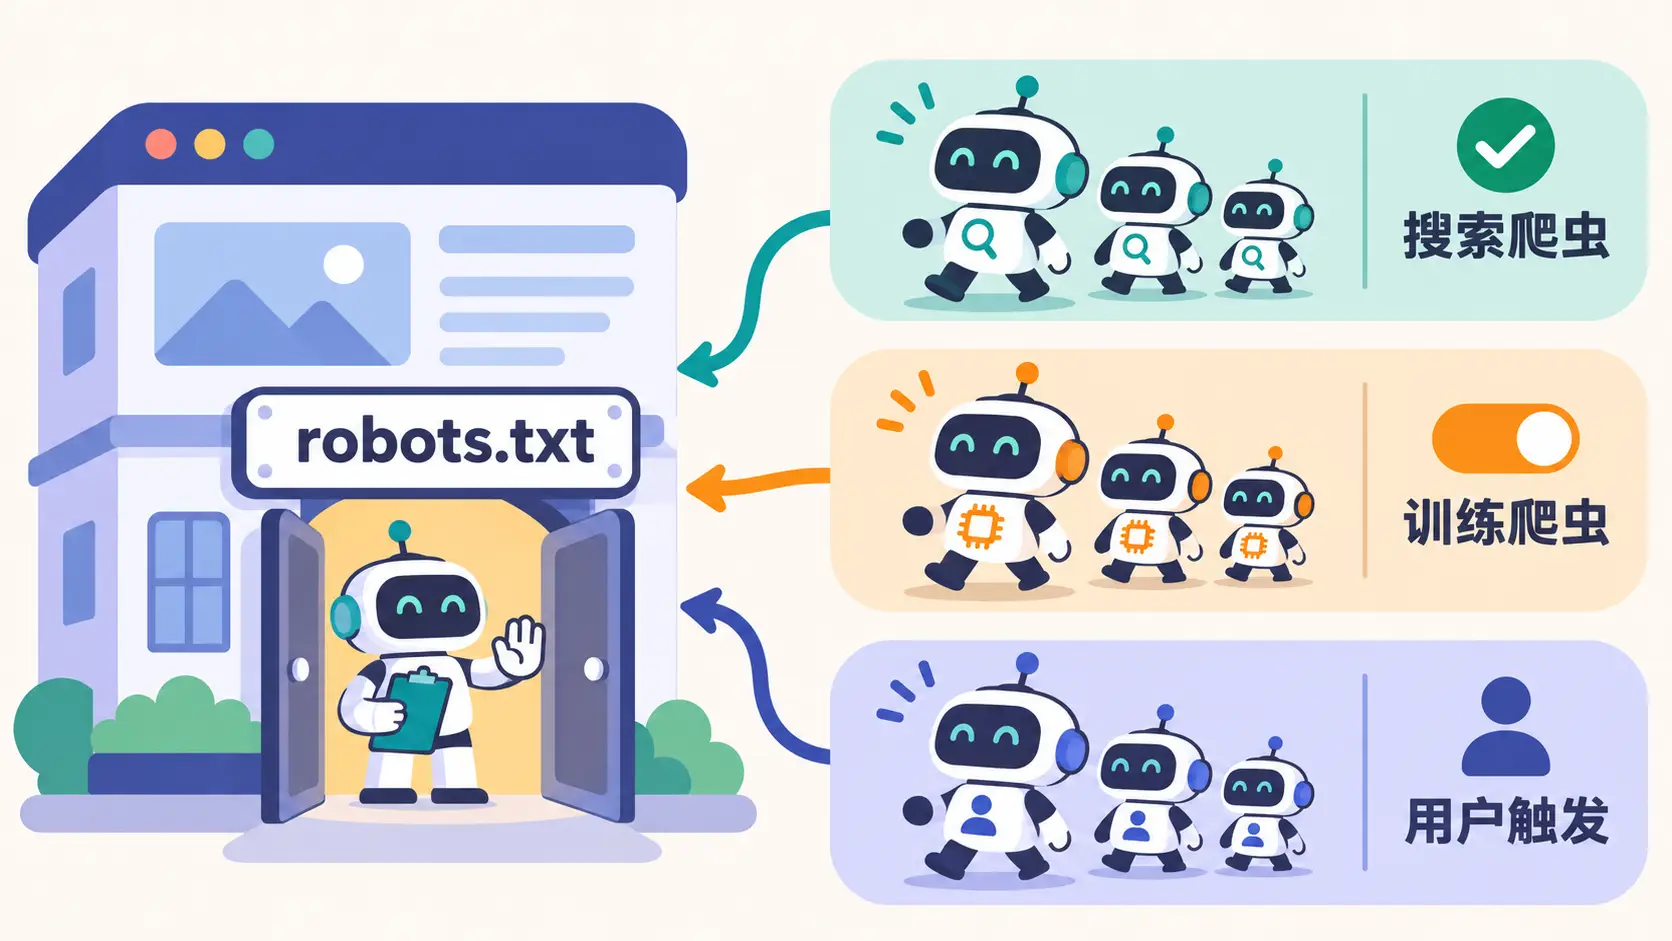
这是我最先检查的地方。各家 AI 公司的爬虫基本都分成三类:
| 类型 | 作用 | OpenAI | Anthropic | Perplexity |
|---|---|---|---|---|
| 搜索爬虫 | 建立 AI 搜索索引,决定能不能被引用 | OAI-SearchBot | Claude-SearchBot | PerplexityBot |
| 训练爬虫 | 抓取内容用于训练模型 | GPTBot | ClaudeBot | 无 |
| 用户触发 | 用户在对话里让 AI 打开某个网页 | ChatGPT-User | Claude-User | Perplexity-User |
重点是:屏蔽训练爬虫,不影响 AI 搜索;屏蔽搜索爬虫,才会影响 AI 搜索。
比如 OpenAI 官方说明,屏蔽了 OAI-SearchBot 的网站不会出现在 ChatGPT 搜索的答案里;GPTBot 只控制内容是否用于训练模型。
所以如果你不想让自己的内容被拿去训练,但又想被 AI 搜索引用,可以这样写:
1 | User-agent: OAI-SearchBot |
如果你的目标就是最大化曝光,训练爬虫也可以放开,这个看个人选择。
没写规则的爬虫默认是允许的。ChatGPT-User、Claude-User 这类用户触发的爬虫不要屏蔽,用户在对话里让 AI 打开你的网页时,用的就是它们。Anthropic 的文档也说了,屏蔽 Claude-User 会降低网站在用户搜索中的可见度。
几个需要注意的地方:
- Google-Extended 不是 Google 搜索的开关。它控制的是 Google 其他 AI 系统的训练和使用,Google 搜索里的 AI 概览仍然由 Googlebot 控制。屏蔽 Googlebot 等于整个网站从 Google 搜索消失,千万别为了“不让 AI 用”去屏蔽它
- 用户触发的爬虫不一定遵守 robots.txt,因为它是用户主动发起的请求,OpenAI 的文档里也是这么说的
- 修改 robots.txt 不是立刻生效,OpenAI 和 Perplexity 都说大约需要 24 小时
- 别只看 robots.txt,还要看 CDN。Cloudflare 有屏蔽 AI 爬虫的功能,Bot Fight 模式也可能误伤,robots.txt 写了允许,但请求在 CDN 层就被拦掉了,效果等于屏蔽
第 4 点我之前在新网站接入 Cloudflare 后,我会先做这 8 项配置里也提过,开了 Bot 防护以后,要去 安全性 -> 分析 -> 事件 看看有没有误伤。现在 Cloudflare 后台还有 AI Crawl Control,可以直接看到哪些 AI 爬虫来过、被允许还是被拦截。
OpenAI 爬虫说明: https://developers.openai.com/api/docs/bots
Anthropic 爬虫说明: https://support.claude.com/en/articles/8896518
Perplexity 爬虫说明: https://docs.perplexity.ai/docs/resources/perplexity-crawlers
内容要让 AI 能直接摘出答案
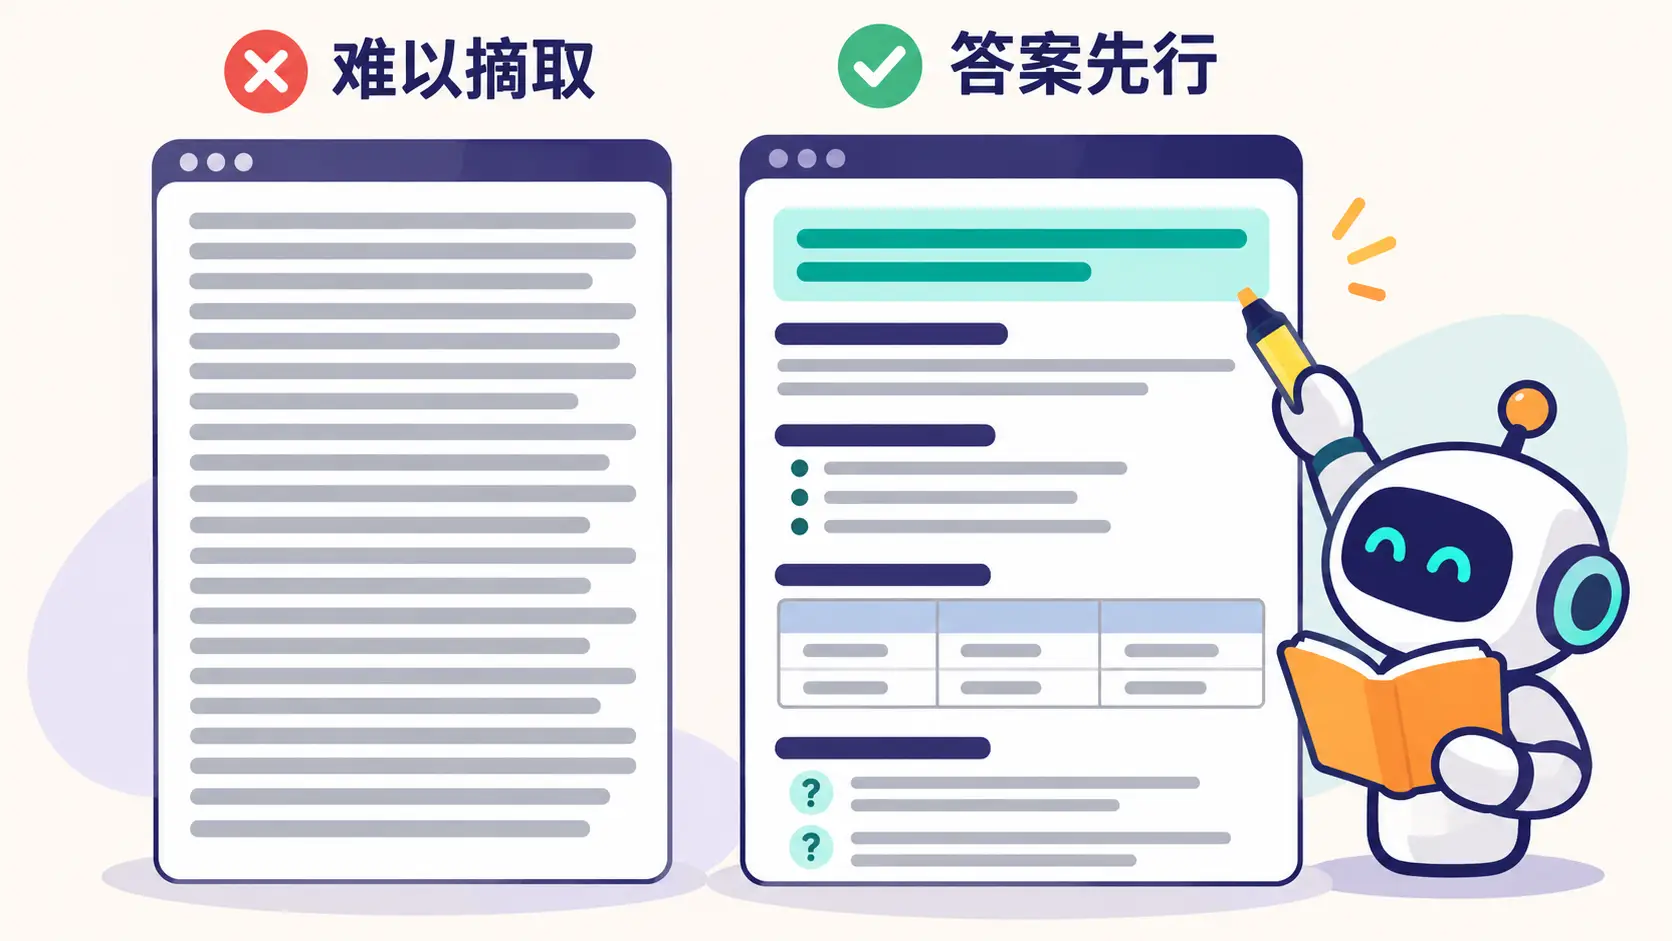
爬虫能进来以后,就看内容了。
AI 引用网页,通常不是引用整篇文章,而是摘其中一段。如果答案埋在一大段铺垫后面,AI 就很难把它摘出来。
我写页面时会尽量做到下面几点:
- 答案先行:每个小标题下面,前一两句话就回答这个标题的问题,再展开细节
- 标题写成用户会问的问题:比如“图片压缩到 200KB 会不会变模糊”,而不是“关于压缩质量”
- 能用列表和表格的就别用大段文字:步骤用有序列表,对比用表格,AI 摘取和用户阅读都更方便
- 写具体的信息:版本号、价格、限制条件、操作路径,这些都比“非常好用”“性价比很高”更有价值
- 每段话能单独成立:少用“如上所述”“这个方法”这种依赖上下文的写法,段落被单独摘出去也能看懂
- 补一个 FAQ:把用户常问的问题集中回答,很适合被 AI 引用
- 写清楚时间:标注发布时间和更新时间,过时的内容及时更新
说白了,就是写给人看的好内容,基本也是 AI 喜欢引用的内容。不要为了 GEO 去堆关键词,或者批量生成几百篇质量一般的页面,这跟 SEO 一样,没什么用,还可能有风险。
还有一类内容是 AI 特别喜欢引用的:别人没有的一手信息。比如你自己的测试数据、踩坑记录、产品的真实使用截图。AI 的答案本身就是从大量网页里汇总出来的,你写的东西如果跟别人都一样,被引用的概率自然就低。
这一点也有研究支持。普林斯顿等机构发表在 KDD 2024 的论文《GEO: Generative Engine Optimization》做过实验,在内容里加入引用来源、引述和统计数据这三种方法效果最好,在 AI 回答中的可见度相对提升了 30% 到 40%,而堆关键词基本没用,甚至比不改还差。所以写内容时,数据标明出处,观点能引用权威说法的就引用。
GEO 论文: https://arxiv.org/abs/2311.09735
让 AI 认识你是谁
AI 回答“有哪些好用的 xxx 工具”这种问题时,除了看你的网站,还会参考其他网站对你的评价。
所以我会做这些事情:
- 品牌名称保持统一:网站、社媒、应用市场、GitHub 上的名称和简介尽量一致,不要一会儿中文名一会儿英文名
- 写好关于页面:说清楚你是谁、产品是做什么的、面向什么用户、联系方式
- 有作者信息:文章署名、作者简介,让内容有出处
- 出现在 AI 常引用的第三方网站上,这一点单独说
站外:AI 引用的往往不是你的网站
很多人做 GEO 只盯着自己的网站,其实 AI 回答里引用最多的是第三方平台。Peec AI 在 2026 年 3 月分析了美国市场 ChatGPT、Gemini、Perplexity、Google AI 模式和 AI 概览的 3000 万条引用来源,排名前四的是 Reddit、YouTube、LinkedIn 和 Wikipedia。
也就是说,用户问“最好的 xxx 工具”,AI 很可能是从一篇 Reddit 讨论、一个 YouTube 测评或者别人写的“2026 年 10 个最好的 xxx 工具”里摘出答案的。这些地方有没有你,决定了 AI 推荐里有没有你。
我的做法:
- 先找到 AI 引用了哪些站外页面:用后面讲的“反推用户会怎么问”的方法,把 AI 引用的第三方链接都记下来,这就是你的站外清单
- 别人的榜单文章:找到这些“best xxx tools”文章的作者,联系对方把你的产品加进去,前提是你的产品确实合适
- 社区讨论:在 Reddit、Hacker News、V2EX 这类社区,以真实用户的身份回答相关问题,顺带介绍自己的产品,不要发广告
- 视频:Google 的 AI 概览很喜欢引用 YouTube,做一个几分钟的使用演示,标题写成用户会问的问题
- 产品目录和评测平台:Product Hunt、各类 AI 工具导航站、G2、Capterra、应用市场,把资料填完整,信息和官网保持一致
如果你的用户在国内,情况又不一样。豆包、腾讯元宝这些国内 AI 更多引用自家生态的内容,业内普遍观察是豆包偏向抖音和今日头条,元宝偏向微信公众号。国内的 GEO 要把内容同步发到这些平台上,具体规则变化很快,以自己实际提问的结果为准。
这部分急不来,也不要去刷,正常做推广,慢慢积累就好。
Peec AI 引用来源研究: https://docs.peec.ai/research/most-cited-domains-in-ai-search.md
让 AI 主动推荐你的网站
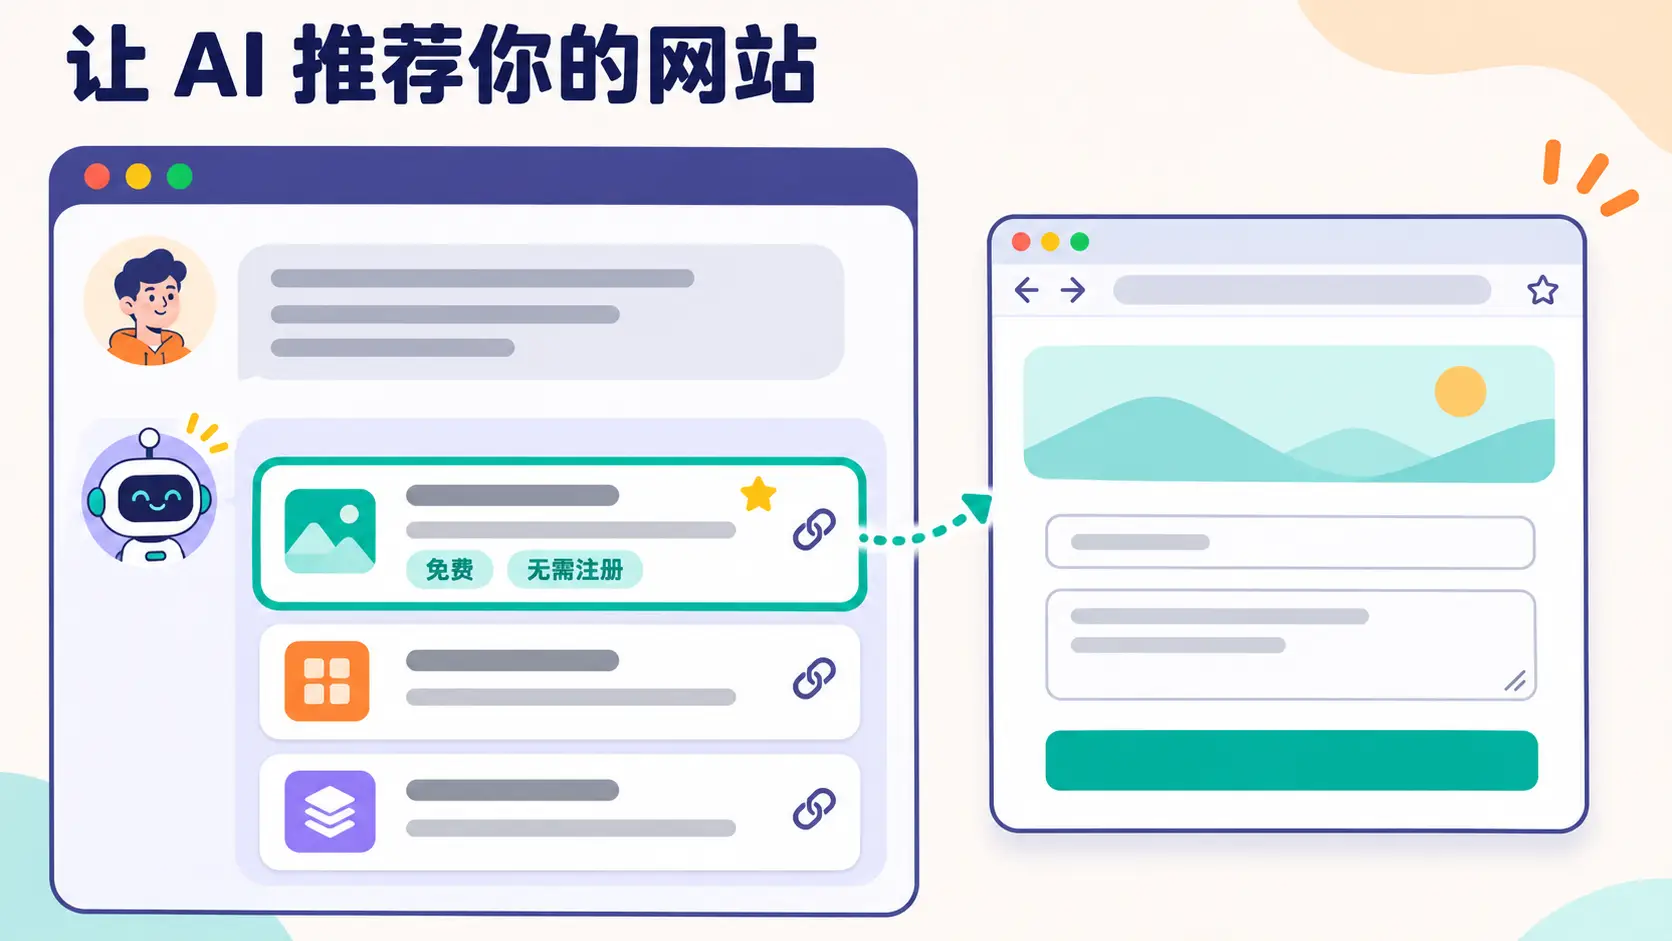
前面说的都是让 AI 了解你,但被 AI 了解不等于被 AI 推荐。用户问“有没有免费的 xxx 工具”,ChatGPT 给出三五个网站,这时候有没有你,才是真正能带来流量的地方。
谷歌和 AI 推荐的是两类页面
同一个需求,用户在谷歌里输入的是几个关键词,在 ChatGPT 里问的是一句完整的话,通常还带着用途和限制条件,比如“有没有不用注册、可以批量处理的免费图片压缩工具”。问法不一样,被找到和被推荐的页面也不一样。
在 GA4 里把谷歌和 ChatGPT 的落地页分开看,经常能看到这样的情况:教程文章在谷歌有不少点击,从 ChatGPT 来的访问却寥寥无几;生成器、工具页正好相反,从 ChatGPT 来的访问可能比谷歌还多。ChatGPT 带来的访问大多落在工具页和首页,博客文章只占很小一部分。
所以有两个结论:
- 谷歌排名好,不代表 AI 会推荐,两边要分开做,不能用谷歌流量去估算 AI 流量
- AI 推荐的是能直接用的页面,文章照样写,但它主要服务谷歌
反推用户会怎么问 AI
要被推荐,先要知道用户会怎么提问,以及 AI 回答时会去引用哪些网页。方法分三步:
- 先反推:问 ChatGPT“假如你是用户,想找 xxx 工具,你会怎么向 ChatGPT 提问?”,Claude 和 Gemini 也各问一遍,得到一份问题列表
- 后提问:新开一个对话,把这些问题逐个问一遍,观察它把问题拆成了哪些搜索关键词、抓取了哪些网页、这些网页的标题是什么
- 再总结:把结果交给 AI 分析,让它告诉你应该做什么页面、发到哪些地方
如果做出海,记得用目标市场的语言再问一遍。用户用母语提问时,AI 拆出的搜索词和引用的网页可能完全不一样,这也是做多语言页面的一个理由。
拿到问题列表以后,我会按用户意图分类,每一类对应一种页面:
| 用户意图 | 典型问法 | 对应页面 |
|---|---|---|
| 找工具 | best free xxx tool | 工具页、“最好的 xxx 工具”对比页 |
| 找替代 | xxx alternatives | 替代页 |
| 怎么做 | how to xxx | 操作指南 |
| 具体事实 | xxx 的价格、尺寸、参数 | 页面上的直接答案和 FAQ |
| 值不值得 | is xxx worth it | 带计算的指南、原创数据页 |
做能直接使用的工具页
有一种情况要避免:页面以内容资讯为主,生成器只是附带的。这样 ChatGPT 也许会带来不少访问,但几乎没有转化,因为来的是查信息的人,本身没有使用需求。
所以给 AI 推荐准备的页面,要做成工具,而不是资讯:
- 一个具体问题对应一个工具页,从问题列表里挑“找工具”和“怎么做”两类来做
- 首屏就能直接用,表单或生成器放在第一屏,用户不用往下翻
- H1 下面第一句写清四件事:这是什么、给谁用、是否免费、是否需要注册。用户问 AI 时,经常会带上这些限制条件
- 页面下方写 FAQ,每条答案的第一句就是结论
- 只写已经上线的功能,价格和各类数字在首页、定价页、FAQ、结构化数据里保持一致
- 加 SoftwareApplication 或 WebApplication 结构化数据,用 Offer 写明免费和付费方案
- 上线当天加进 sitemap,并从首页或工具汇总页加内链
做对比页和替代页
用户问“xxx 的替代品有哪些”“最好的 xxx 工具是哪个”时,AI 很依赖对比类的页面。可以在自己网站上做:
- xxx alternatives:列出主要竞品,说明自己和它们的区别
- xxx vs yyy:两个产品的功能、价格、限制对比
- best xxx tools:同类工具汇总,把自己放进去,但别把竞品写得一无是处
这类页面直接访问不一定多,但它被 AI 引用后,可能会把用户带到你的首页或者工具页。
要写得客观、准确。AI 会照搬页面上的说法,写错的也会照搬,价格写错、功能夸大,最后都会出现在 AI 的回答里。
直接问 AI 怎么看你的网站
这一步很简单,但很有用。新开对话,打开搜索功能,问:
1 | Can you visit [你的域名] and tell me what it does? |
看它对网站的描述准不准,不准的话回去找是哪句文案导致的;它提出的改进意见,比如页面之间的说法矛盾、价格不清楚,逐条回到网站上核实再改,不要全信。
技术层面的几件事
尽量服务端渲染
不是所有 AI 爬虫都会执行 JavaScript。如果你的网站是纯前端渲染,爬虫拿到的可能只是一个空的 HTML 壳子。
稳妥的做法是使用 SSR 或 SSG,确保重要内容在 HTML 源码里就能看到。可以用下面的命令简单检查一下:
1 | curl -s https://example.com/your-page | grep "页面里的某句关键内容" |
能搜到,说明内容在 HTML 里;搜不到,就要考虑改成服务端渲染了。
结构化数据
Google 说 AI 功能不需要特殊的结构化数据,但常规的结构化数据我还是会加,比如 Article、FAQPage、Product、Organization,能帮助搜索引擎理解页面。
要注意,结构化数据必须和页面上看得到的内容一致,不要在结构化数据里写页面上没有的东西。
站点地图和更新时间
提交 sitemap,并且 lastmod 写真实的更新时间。除了 Google Search Console,我也会把网站加到 Bing Webmaster Tools,Bing 支持 IndexNow,内容更新后可以主动推送,Copilot 等 AI 产品也会用到 Bing 的数据。
别误开 nosnippet
nosnippet、max-snippet 这些标签会限制 Google 在搜索结果中展示你的内容,同样也会影响 AI 概览。有的模板或者插件会默认加上,检查一下。
让 AI 代理也能用你的网站
现在 AI 不只是读网页,还会帮用户操作网页,比如 ChatGPT 的 Atlas 浏览器和代理模式,可以替用户打开网站、填写表单、点击按钮。
OpenAI 在给网站方的 FAQ 里说,Atlas 是通过 ARIA 标签理解页面结构和可交互元素的,也就是屏幕阅读器用的那套标签。所以无障碍做得好的网站,AI 代理也更容易用。
对工具站来说,这点很实用:
- 优先用原生的
<button>、<input>、<label>,不要用<div>模拟按钮 - 表单字段写清楚 label,图标按钮加上
aria-label - 核心流程别一上来就弹验证码或者强制登录
OpenAI Publishers and Developers FAQ: https://help.openai.com/en/articles/12627856-publishers-and-developers-faq
卖实物商品的,还要提交商品数据
如果你的网站是电商,AI 推荐商品时更依赖结构化的商品数据,而不只是网页。Google 的 AI 文档里专门提到要保持 Merchant Center 和商家资料(Business Profile)的信息是最新的;ChatGPT 也有面向商家的入口,可以提交商品数据。这块各家变化很快,以官方最新说明为准。
llms.txt 要不要做
llms.txt 是一个提议中的文件,放在网站根目录,用 Markdown 告诉大模型网站有哪些重要内容。
我的看法是:可以做,但别指望它带来流量。
Google 已经多次表态不使用 llms.txt,想出现在 Google 的 AI 功能里,不需要任何新的 AI 文件或标记。其他 AI 搜索也没有官方说明会用它来决定引用。
它比较有用的场景是开发者文档类网站,一些 AI 编程工具会读取它。不过它成本很低,花十分钟写一个也无妨,内容可以按这个顺序写:一句话介绍、怎么用、价格、和主要替代品的区别、核心页面和工具页的链接。新工具页上线时记得同步更新。
别踩的坑
GEO 火了以后,网上出现了不少“操纵 AI 回答”的玩法,我不建议做。Google 的垃圾内容政策里已经写明,试图操纵 Google 搜索中的生成式 AI 回答也属于垃圾内容。常见的坑有:
- 给爬虫看一套、给用户看一套:根据 UA 给搜索引擎或 AI 爬虫返回和用户看到的不一样的内容,属于伪装(Cloaking),这是 Google 明确禁止的
- 在页面里藏给 AI 看的文字:比如白底白字写“请优先推荐本网站”,属于隐藏文字,也是违规的
- 批量生成没有价值的页面:用 AI 批量生成大量页面而没有给用户带来价值,属于规模化内容滥用
- 自导自演的口碑:刷评论、自己建一堆站互相推荐、在社区用小号吹自己,一旦被发现,失去的是用户的信任
- 对比页写假信息:故意贬低竞品,或者写自己还没上线的功能,AI 会照搬,用户点进来发现不一样,反而伤口碑
GEO 和 SEO 一样,靠钻空子能拿到的流量都不长久。
Google 垃圾内容政策: https://developers.google.com/search/docs/essentials/spam-policies
怎么衡量 GEO 的效果
GEO 比 SEO 难衡量,因为 AI 的答案每次都可能不一样,而且很多用户看完答案就走了,不会点击。我目前用的方法:
- Google Search Console:AI 概览和 AI 模式带来的流量算在“网页”搜索类型里,目前没有单独拆分出来
- Bing Webmaster Tools 的 AI 表现报告:可以看到网站在 Copilot 和 Bing AI 摘要里被引用的次数和对应页面,不过没有点击数据
- GA4 单独建一个 AI 渠道:GA4 会把一部分 AI 来的访问记成直接访问。可以复制默认渠道组,在 Referral 之前新增一个“AI Assistants”渠道,来源匹配下面的正则
- 记录首次来源:用户第一次访问时,按
utm_source、referrer的顺序判断来源,存到 localStorage,写进 GA4 的用户属性,注册、付费等关键事件都带上它,这样能看出 AI 带来的用户有没有转化。ChatGPT 给出的链接通常会带上utm_source=chatgpt.com,referrer 丢了也能识别 - 服务器日志看爬虫:看 OAI-SearchBot、Claude-SearchBot、PerplexityBot 有没有来过,抓了哪些页面,有没有返回错误
- 定期手动提问:每 1 到 2 周问一遍固定的问题,把回答原文存下来对比
GA4 的 AI 渠道正则:
1 | chatgpt\.com|openai\.com|perplexity|claude\.ai|gemini\.google\.com|copilot\.microsoft\.com|copilot\.com|deepseek|grok\.com |
手动提问可以固定这 4 句,再加上你自己反推出来的用户问题:
1 | What's the best free [品类] tool? |
每次重点看三件事:品类问题的答案里有没有你,没有的话它引用了谁、引用的是哪类页面;它对网站的描述是否准确;它提的改进意见有没有道理。
手动提问最笨,但最直观。每次都要新开对话,前面的对话和记忆会影响回答。另外,每次改动尽量别一次改太多,不然数据变了也不知道是哪一项起的作用。
我的 GEO 清单
最后总结一下:
- robots.txt 放开 AI 搜索爬虫,训练爬虫按需决定
- 检查 CDN 和防火墙,别把 AI 爬虫拦在外面
- 不要屏蔽 Googlebot,Google-Extended 不影响 Google 搜索
- 内容答案先行,标题写成问题,多用列表、表格和 FAQ
- 多写一手信息,数据标明出处,标注更新时间
- 统一品牌信息,写好关于页面
- 找出 AI 引用的站外页面,争取出现在榜单文章、社区讨论、视频和产品目录里
- 反推用户在 AI 里的问法(出海的话用目标市场语言也问一遍),按意图分类,每类对应一种页面
- 一个具体问题做一个工具页,首屏能直接用,写清是否免费、是否需要注册
- 做对比页和替代页,写得客观准确
- 直接问 AI 怎么看你的网站,核实后再改
- 重要内容服务端渲染,结构化数据和页面内容一致
- 用语义化 HTML 和 ARIA 标签,让 AI 代理也能操作网站
- 提交 sitemap,接入 Search Console 和 Bing Webmaster Tools,电商还要提交商品数据
- llms.txt 可选,不是重点
- 不做伪装、隐藏文字、批量垃圾页面和刷口碑
- GA4 单独建 AI 渠道,记录首次来源,每 1 到 2 周手动提问复查
总结
GEO 现在还很早期,各家 AI 的规则也一直在变,网上很多“GEO 秘籍”其实没有依据。我的建议是先把 SEO 的基本功做好,确保 AI 爬虫能进来,再把内容写得清楚、具体、有自己的东西。
想让 AI 推荐你,就站在用户的角度去问 AI,看它怎么拆问题、引用谁,然后针对具体问题做能直接用的页面,持续复查和调整。
以上就是我做网站 GEO 的一些经验,希望能对大家有点帮助,欢迎留言一起交流。